
¿Por qué fracasa tu IA de repuestos? Errores comunes y victorias reales – Podcast con Jeromy Risner


En el artículo anterior vimos cómo un gemelo digital convierte el FMEA en un modelo vivo y genera órdenes de trabajo cuando la condición del activo lo exige. Pero esa orden es sólo la mitad del ciclo. La otra mitad ocurre en el taller, cuando el técnico la cierra.
Si la orden se cierra con "Falla general" o "Otros", o si el trabajo se hace sin orden, la estrategia deja de recibir información. El plan sigue existiendo en ingeniería, pero ya no sabe qué pasa en la planta. A esto lo llamamos órdenes de trabajo fantasma.
Una orden fantasma es trabajo de mantenimiento que ocurre, pero que el sistema no registra o registra mal. Tiene dos formas:
En ambos casos, la máquina vuelve a operar. El problema es que el historial de mantenimiento ya no refleja lo que realmente le pasó al activo.
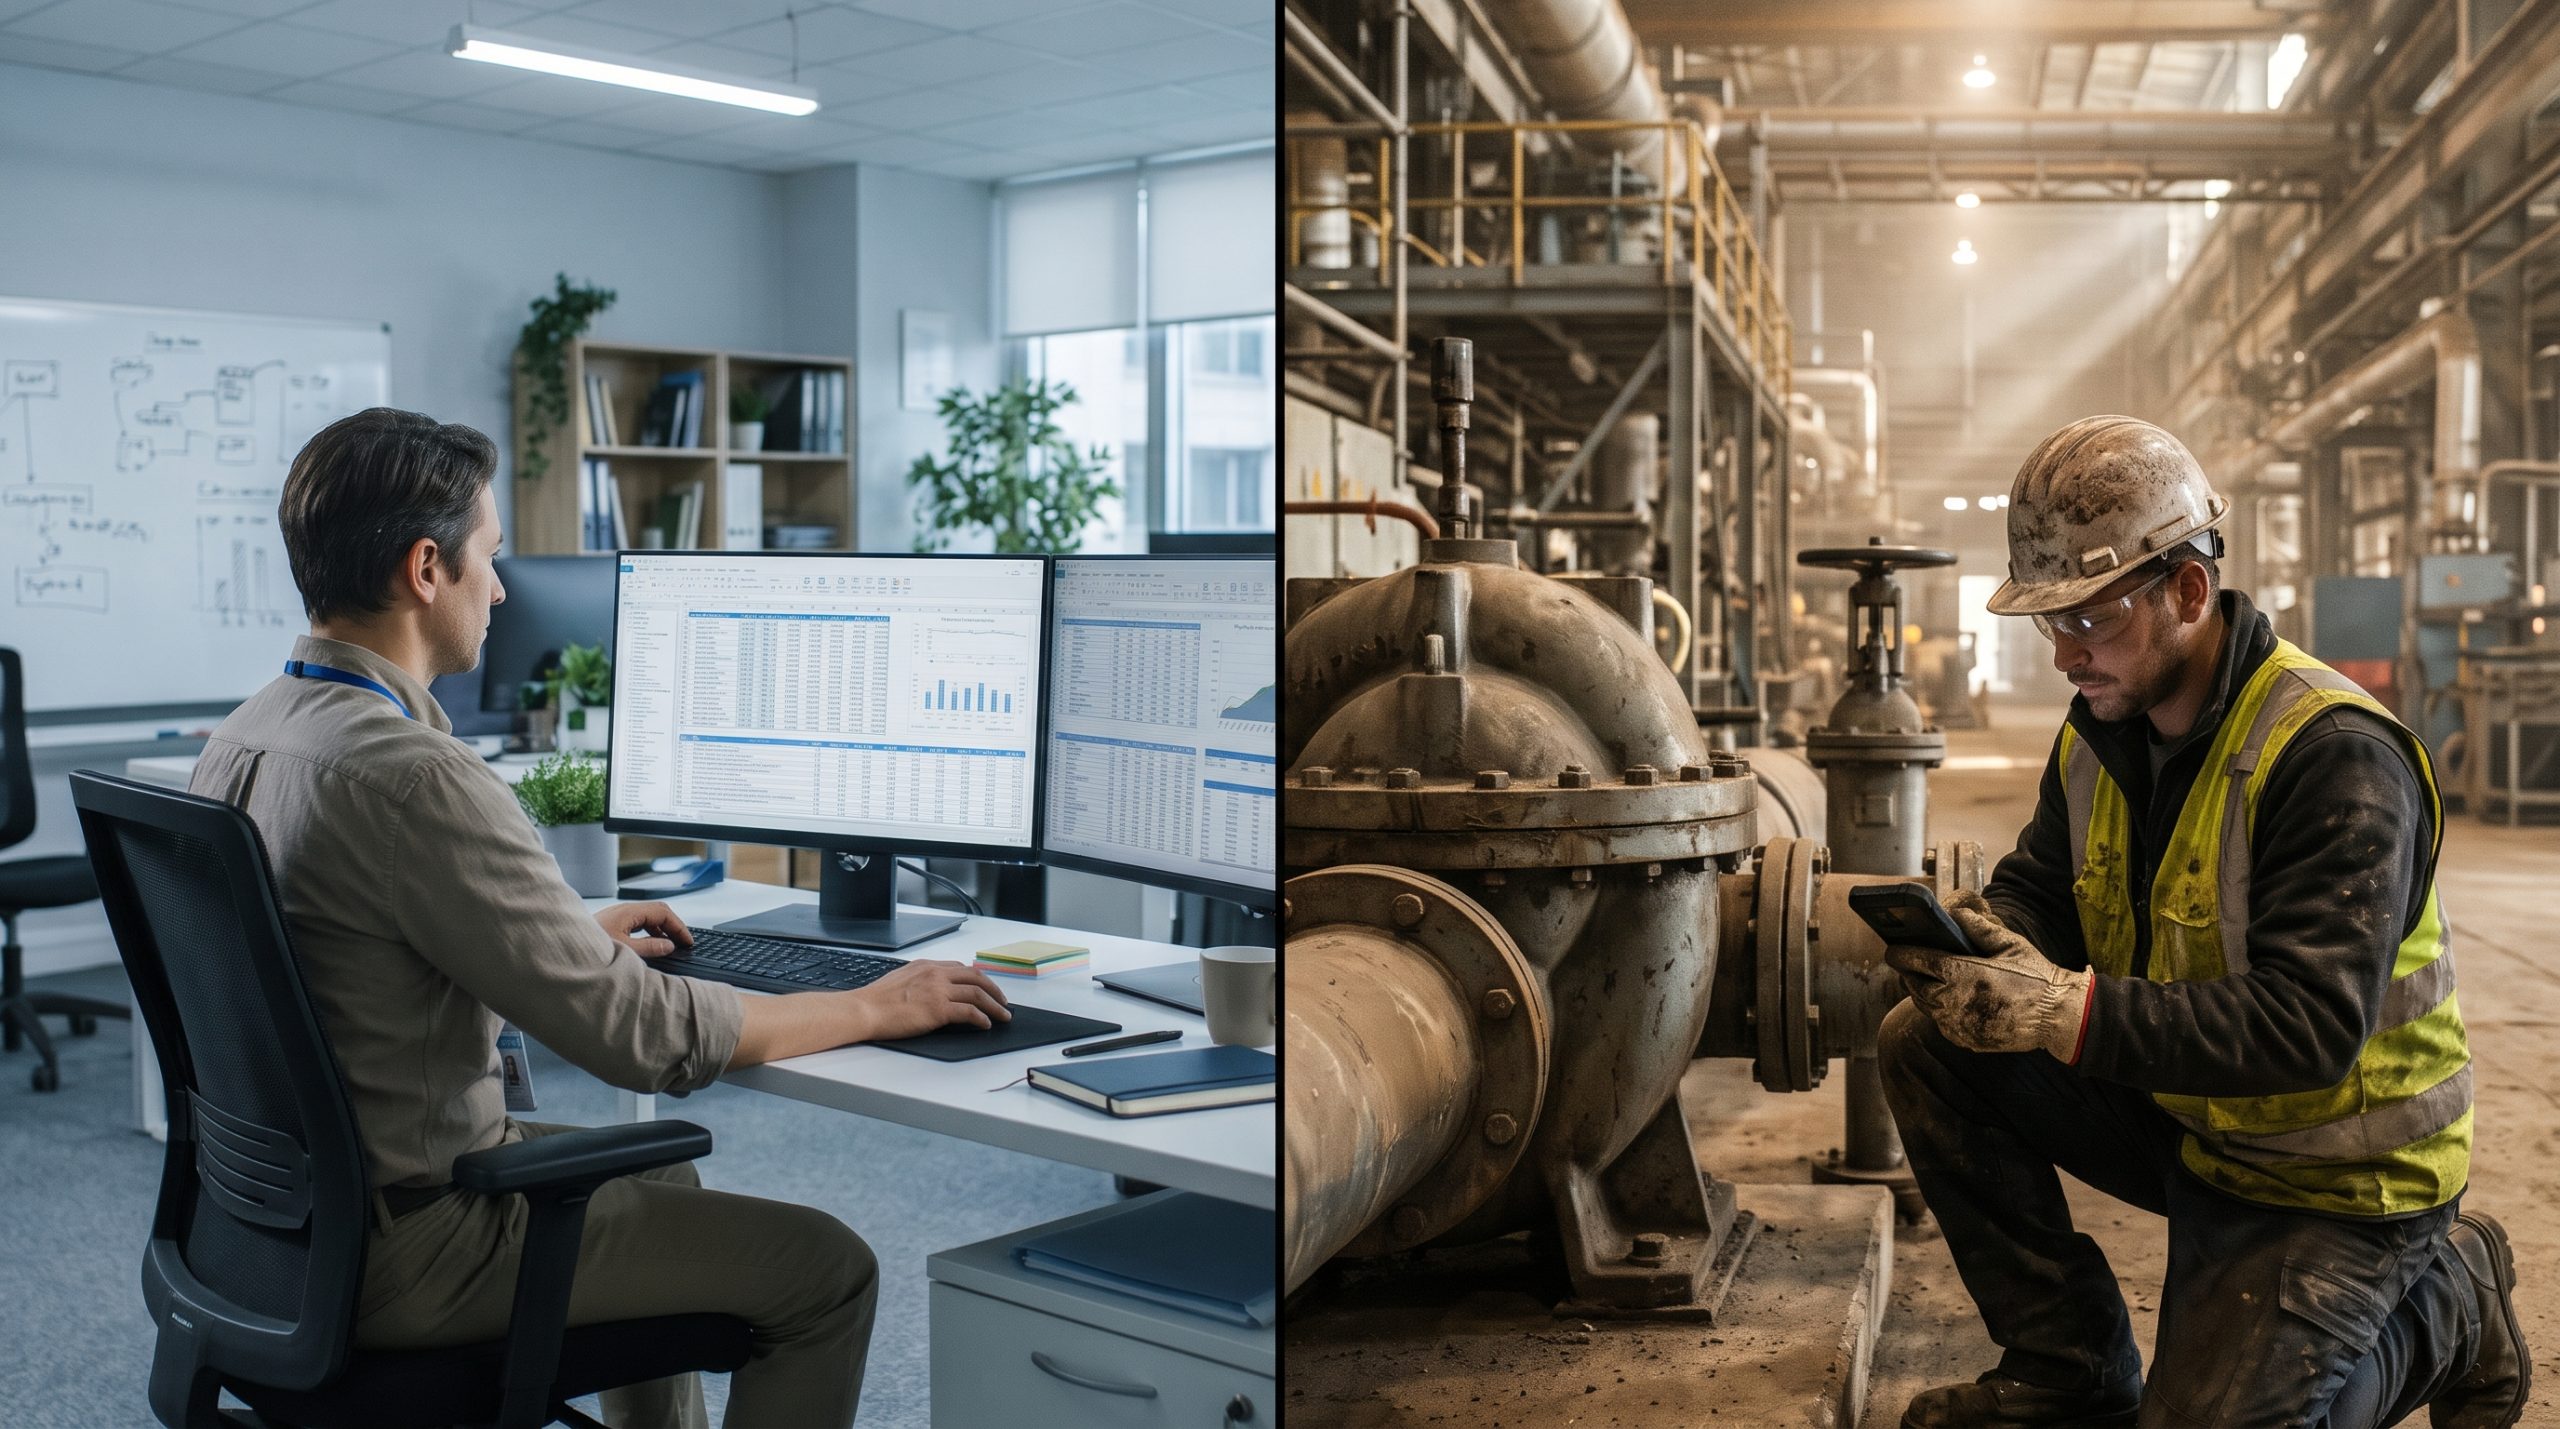
La brecha entre la estrategia y el taller: plan de mantenimiento frente a la realidad del taller
Las órdenes fantasma no nacen por mala intención del técnico. Su prioridad es que la máquina vuelva a producir, no mantener limpia la base de datos. Cuando registrar bien es más difícil que reparar, el técnico toma el atajo. Hay tres causas frecuentes:
Cuando una parte importante del trabajo pasa por órdenes fantasma, la planta sigue operando, pero las decisiones se toman sobre datos que no representan la realidad:
La trazabilidad perdida en el taller: etiqueta de inspección en una válvula industrial con datos manuscritos incompletos
Eliminar las órdenes fantasma no requiere más vigilancia ni sanciones al personal de campo. Requiere que registrar bien sea más fácil que registrar mal. En la práctica son cinco pasos:
La sincronización entre la planeación y el campo
Una empresa de midstream de petróleo y gas enfrentaba un escenario conocido. Sus estudios RCM estaban desactualizados y nunca se habían operacionalizado. Los datos de sus órdenes de trabajo estaban incompletos, sobre todo en costos. El monitoreo de condición existía, pero no se usaba para el análisis, y los preventivos se programaban de forma inconsistente, lo que generaba trabajo innecesario.
Con un análisis de riesgo de sus activos como punto de partida, la empresa enfocó sus estrategias de mantenimiento en los modos de falla y en las intervenciones que realmente reducían el riesgo. El resultado fue un ahorro de más de US$1 millón y una base para tomar decisiones con análisis de confiabilidad, replicable a otras clases de activos.
El trabajo de confiabilidad no termina cuando se define la estrategia. Termina cuando el técnico ejecuta la tarea correcta, con la información correcta, y deja registrado lo que encontró. Ese registro es lo que permite que el FMEA, el gemelo digital y los indicadores reflejen la planta real.
¿Cuánto puedes confiar hoy en los datos de tus órdenes de trabajo? Te ofrecemos un diagnóstico de calidad de órdenes de trabajo: revisamos una muestra de OTs cerradas y te mostramos qué porcentaje tiene un código de falla válido, cuántas están vinculadas a un modo de falla del FMEA y dónde se pierde la información. Déjanos un comentario o escríbenos para agendarlo. Conoce también nuestras soluciones de Gestión de Activos y Mantenimiento (EAM) y Gestión del Rendimiento de Activos (APM).

La mayoría de los estudios de Mantenimiento Centrado en la Confiabilidad (RCM) terminan igual: una matriz de Análisis de Modos y Efectos de Falla (FMEA) en Excel, impecable, con cientos de modos de falla, causas, efectos y tareas. El problema no es el Excel. El problema es creer que un plan de tareas calendarizadas protege el activo.
Cargar esas tareas en el sistema de mantenimiento y generar las órdenes de trabajo preventivas es un primer paso indispensable. Pero entre una inspección y la siguiente el activo sigue operando, y ahí es donde la mayoría de las estrategias pierde visibilidad.
Un RCM bien hecho no produce sólo tareas por tiempo. Para muchos modos de falla, la tarea correcta es la condición: medir vibración, temperatura o calidad de aceite y actuar cuando el indicador cambia.
En la práctica, esas tareas suelen ejecutarse como rondas manuales: un técnico mide la vibración una vez al mes. Es mejor que nada, pero en el fondo sigue siendo un calendario. La tarea dice "a condición"; la ejecución dice "cada 30 días".
Un rodamiento, una bomba o un motor no falla porque cumplió 30 días en el almanaque. Falla por esfuerzo, contaminación, lubricación inadecuada, desalineación o cavitación.
El estudio clásico de Nowlan y Heap en la aviación comercial mostró que la mayoría de los modos de falla no tiene relación con la edad del componente. Para esos modos, revisar o reemplazar "por fecha" no reduce el riesgo. Lo que sí funciona es detectar la falla potencial a tiempo.
Monitoreo físico en planta
La curva P-F describe dos momentos de un modo de falla. P es cuando la falla ya es detectable (falla potencial). F es cuando el equipo deja de cumplir su función (falla funcional). El tiempo entre ambos es el intervalo P-F.
La regla es simple: el intervalo de inspección debe ser menor que el intervalo P-F; como referencia práctica, la mitad o menos. Si un defecto de rodamiento tarda varias semanas en pasar de detectable a falla, una ronda mensual puede captarlo. Pero si el intervalo P-F se mide en días, el técnico que llega el día 30 no previene nada. Solo documenta la falla.
Muchos modos de falla críticos tienen intervalos P-F cortos o difíciles de predecir. Para ellos, la única forma de cubrir la ventana es medir de forma continua.
Inspección periódica contra escucha continua
Las órdenes de trabajo periódicas entregan fotografías: confirman que la tarea se programó y que el técnico la ejecutó. No dicen qué pasó entre una fotografía y la siguiente.
El monitoreo de condición entrega la película completa. Vibración, temperatura, presión o calidad de aceite se leen de forma continua. Cuando una variable cruza su umbral, el sistema la relaciona con el modo de falla del FMEA que la explica y dispara una orden de trabajo por condición.
El resultado es doble: se deja de intervenir equipos sanos solo porque "les tocaba", y se interviene a tiempo a los que realmente se están degradando.
Unir el FMEA, las órdenes de trabajo y el monitoreo de condición requiere un lugar donde las tres piezas convivan. Ese lugar es el gemelo digital del activo dentro de una plataforma de Gestión del Rendimiento de Activos (APM), como Octave Attune APM.
El gemelo no es una réplica 3D del equipo. Es el FMEA convertido en un modelo vivo, construido con tres elementos:
Así se ve el gemelo de una bomba centrífuga en Octave Attune APM:
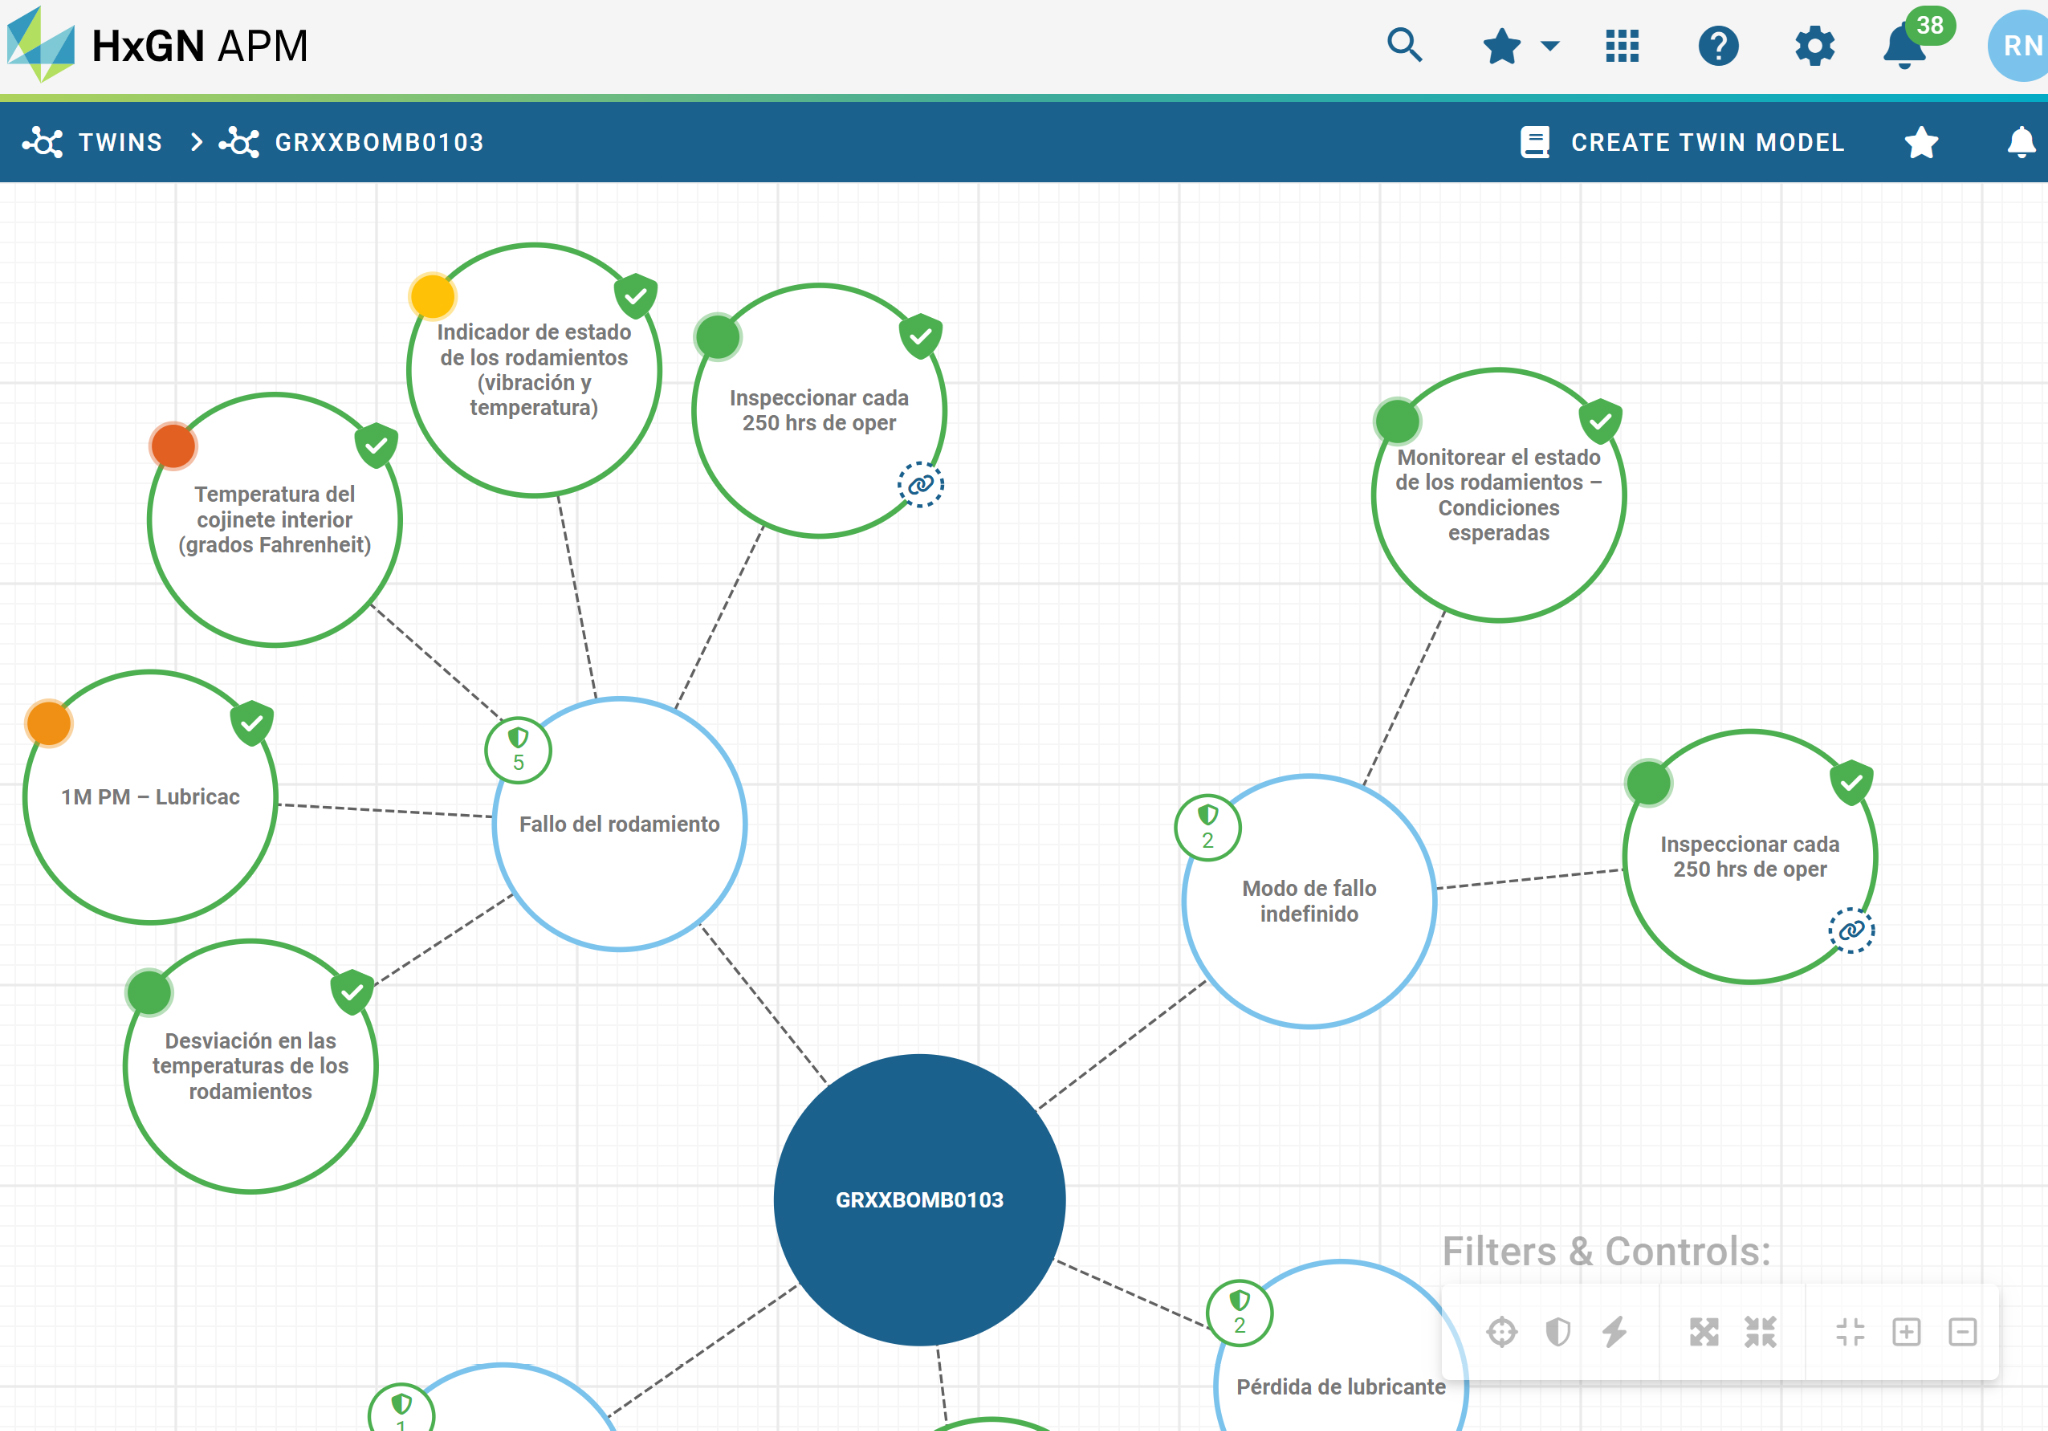
[Imagen: Gemelo digital de la bomba GRXXBOMB0103 en Octave Attune APM. Cada modo de falla muestra sus protecciones y el color de cada protección indica su estado actual.]
En el modo de falla "Fallo del rodamiento", por ejemplo, el gemelo reúne cinco protecciones de naturaleza distinta:
| Protección | Tipo |
|---|---|
| Indicador de estado de los rodamientos (vibración y temperatura) | Monitoreo continuo |
| Temperatura del cojinete interior | Monitoreo continuo |
| Desviación en las temperaturas de los rodamientos | Regla analítica |
| Lubricación mensual | Preventivo por calendario |
| Inspección cada 250 horas de operación | Inspección por uso, vinculada al EAM |
La diferencia con el Excel es inmediata. El calendario y la condición dejan de competir: conviven en el mismo modelo, y cada señal llega asociada al modo de falla que explica. El gemelo también deja a la vista lo que el Excel esconde, como un modo de falla sin protecciones o uno protegido solo por calendario.
Un gerente de mantenimiento no puede revisar cientos de tendencias de vibración cada mañana. Necesita saber qué activos atender primero. El gemelo digital resume todo lo anterior en dos indicadores.
Índice de salud. Consolida el estado de todas las protecciones de un activo en un solo valor. Si el sensor de temperatura del cojinete se acerca a su límite y la lubricación está vencida, la salud del modo de falla "Fallo del rodamiento" baja, y con ella la del activo. Responde a la pregunta: ¿qué tan cerca está este equipo de fallar?
Riesgo. Combina la salud con la consecuencia de la falla, que viene del análisis de criticidad. Dos bombas con la misma salud no tienen el mismo riesgo si una alimenta la línea principal y la otra tiene respaldo. Responde a la pregunta: ¿cuánto le costaría a la planta que este equipo falle hoy?
Con estos dos indicadores la conversación cambia. Ya no se discute si una tarea se cumplió en fecha, sino qué activos concentran el riesgo de la planta esta semana y qué modo de falla lo explica. Las órdenes de trabajo se priorizan por riesgo real, no por el orden del calendario.
No hace falta modelar toda la planta el primer día. El monitoreo continuo tiene un costo y se justifica donde la consecuencia de la falla es alta y el intervalo P-F es corto o impredecible. Por eso el gemelo se construye por etapas:
El resultado es un modelo que crece activo por activo y que se ajusta a medida que el equipo envejece o cambian los objetivos del negocio.
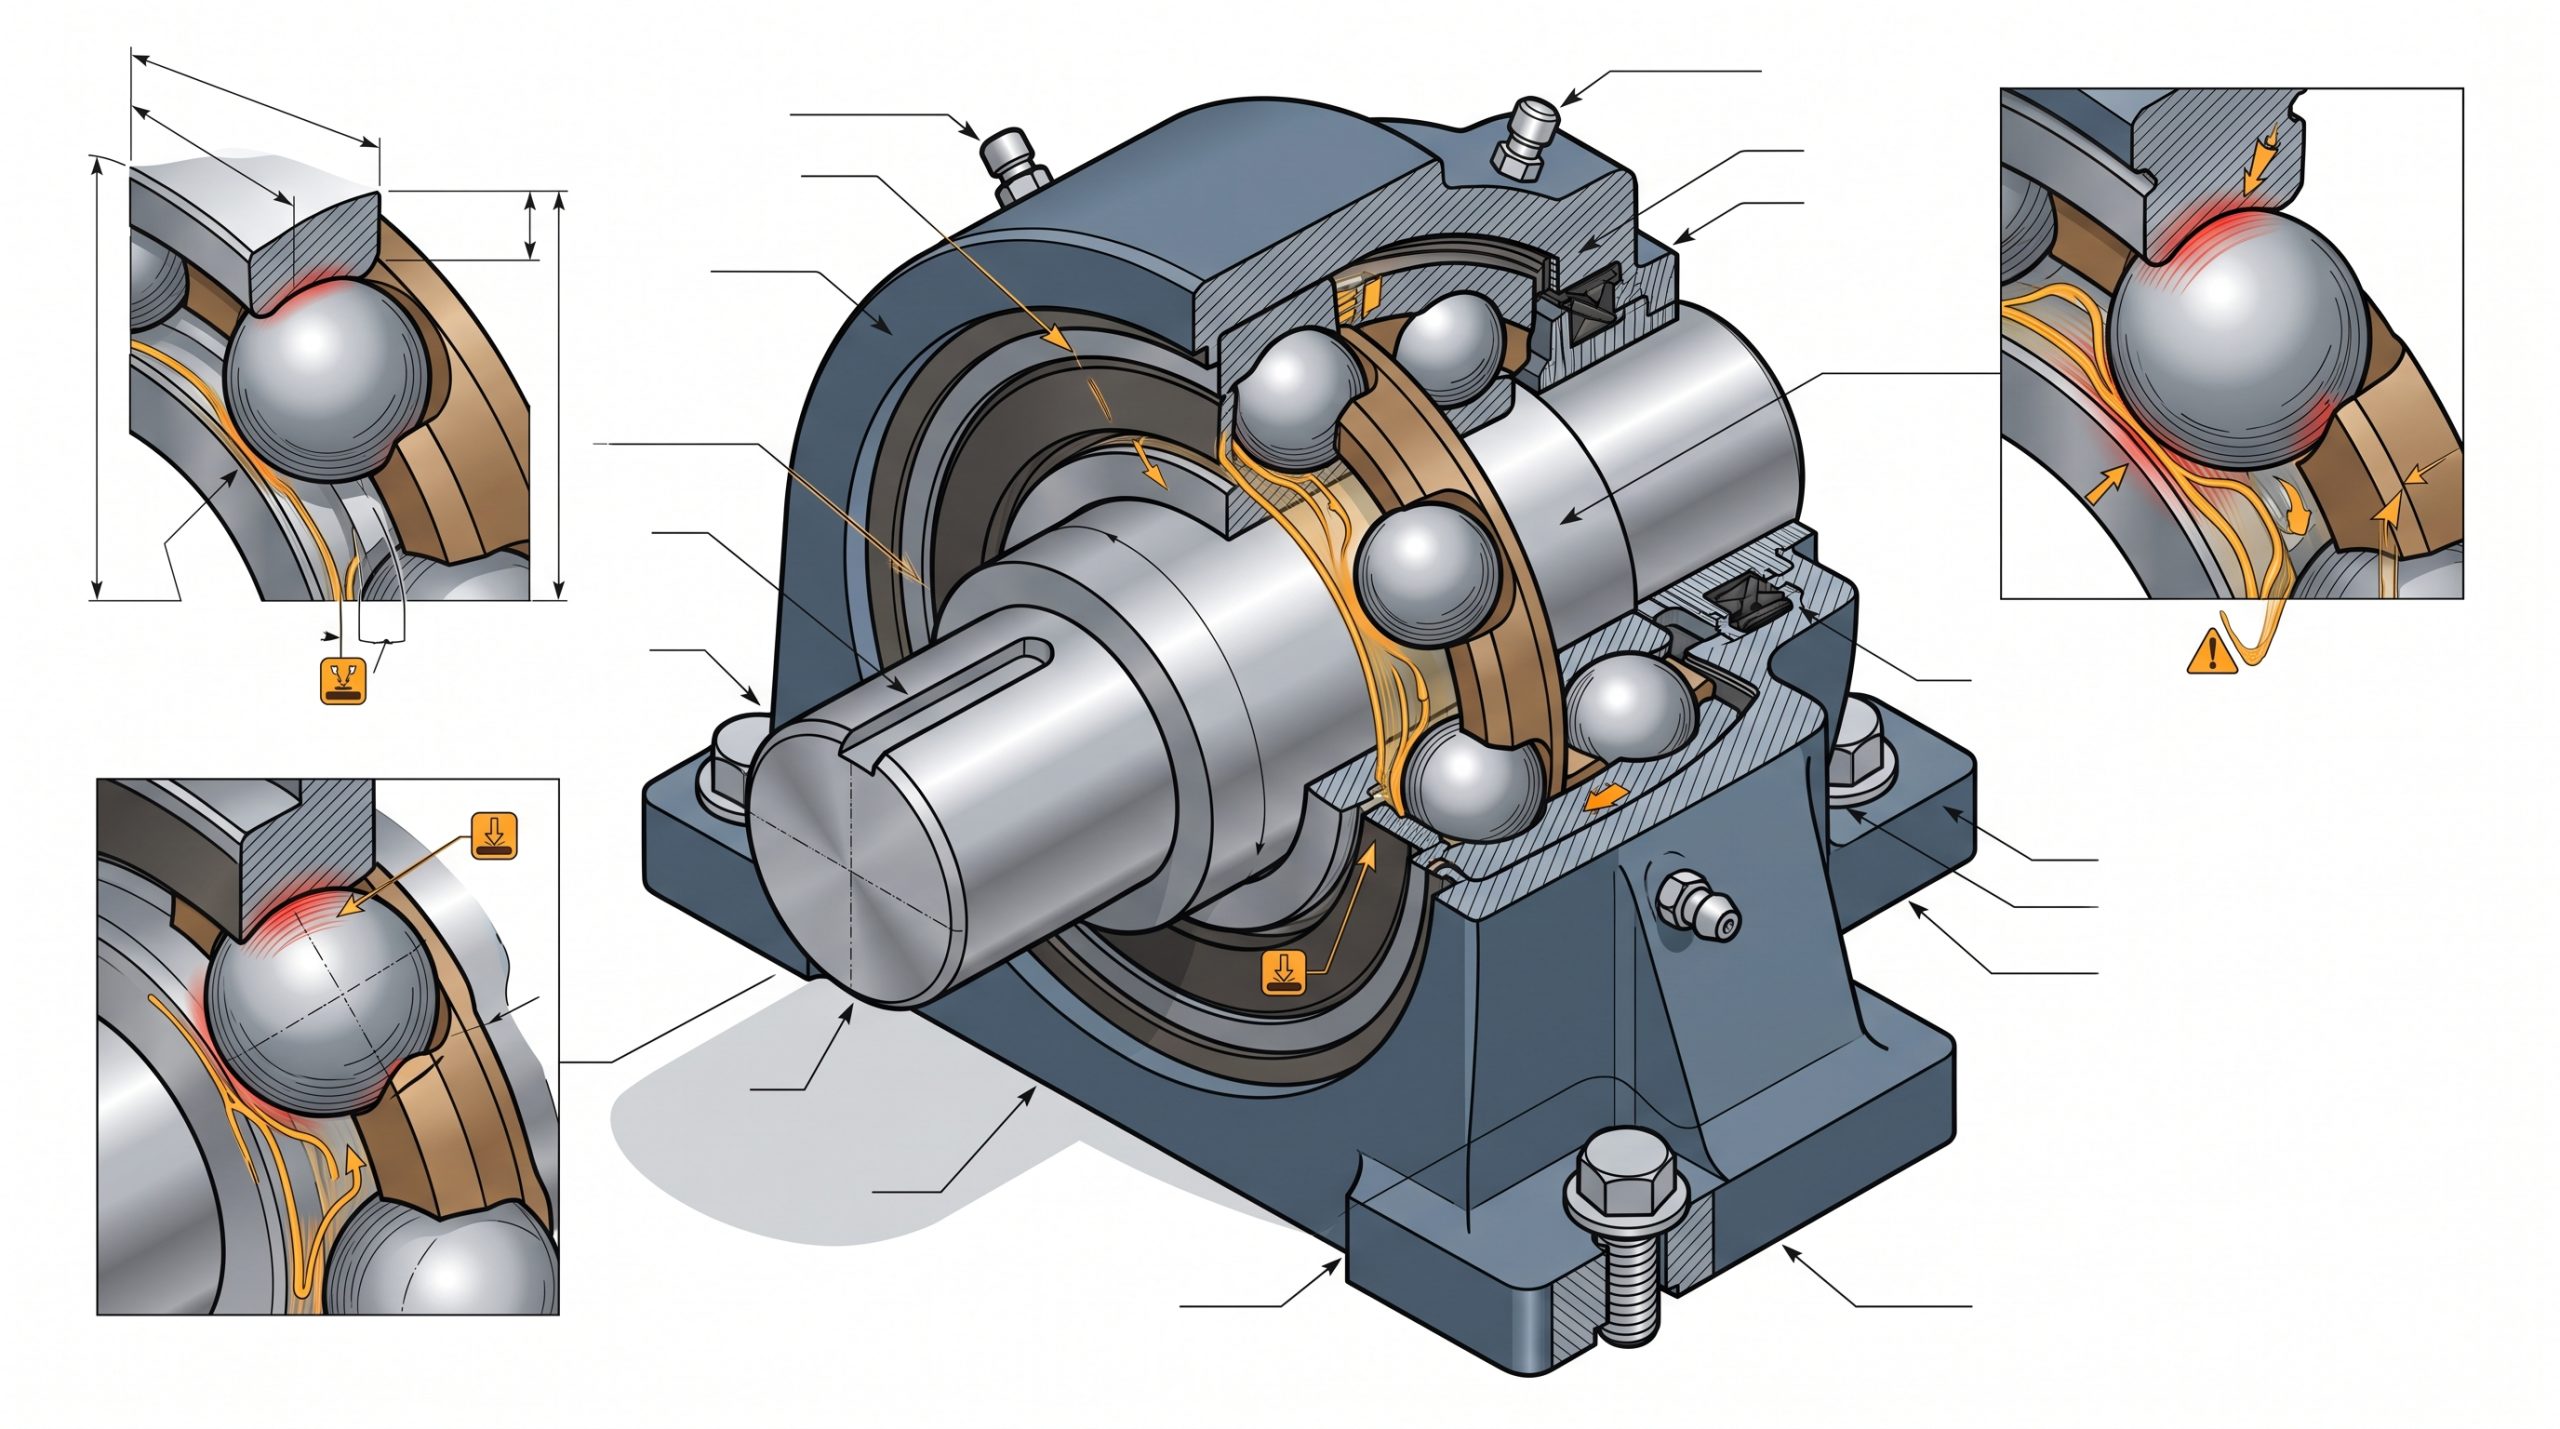
Mecánica y física del componente: fricción, lubricación y fatiga térmica
Una planta de celulosa y papel tenía un problema conocido: sus bombas fallaban en promedio cada 35 días. En dos años, el mantenimiento de esas bombas superó los US$225,000. Las rondas de los operadores existían, pero no lograban captar las señales tempranas de falla.
Es exactamente el escenario de este artículo: tareas ejecutadas por calendario y fallas que avanzaban entre una ronda y la siguiente.
Al replantear la confiabilidad de sus bombas con HxGN APM, hoy Octave Attune APM, la planta pasó de un ciclo de reparaciones a un modelo predictivo:
No es un caso aislado. Una empresa de midstream de petróleo y gas tenía estudios RCM desactualizados que nunca se habían operacionalizado y un monitoreo de condición que no se usaba para el análisis. Al enfocar sus estrategias de mantenimiento en los modos de falla y el riesgo, ahorró más de US$1 millón.
La matriz FMEA es el fundamento: estructura las fallas. Las órdenes de trabajo son las manos que ejecutan en el taller. El monitoreo de condición aporta la lectura continua del equipo. El gemelo digital es lo que une las tres piezas y las traduce en salud y riesgo por activo.
Con ese modelo, el estudio RCM deja de ser un entregable que se archiva y se convierte en la forma diaria de gestionar el activo: qué equipo atender, por qué modo de falla y con qué urgencia.
¿Quieres ver un gemelo digital en acción? Déjanos un comentario en este blog y te mostramos cómo se ve el gemelo de un activo crítico en Octave Attune APM, con sus modos de falla, protecciones, índice de salud y riesgo. También puedes conocer nuestras soluciones de Gestión de Activos y Mantenimiento y Gestión del Rendimiento de Activos.
Imagina que acabas de gastar un dineral en un activo industrial nítido, de última tecnología —una turbina enorme, una línea de manufactura o una bomba centrífuga gigante. Lo primero que hace cualquiera es correr a buscar el manual del fabricante (el famoso OEM) y seguirlo al pie de la letra. Parece la decisión más sensata y segura, porque ¿quién va a conocer mejor la máquina que el que la diseñó?
Pues aquí está el verdadero desafío: seguir el manual del fabricante a ciegas limita el potencial de confiabilidad de tu planta y diluye la efectividad de tu presupuesto. El Mantenimiento Centrado en la Confiabilidad (RCM) nos enseña que el secreto no está en la máquina en sí, sino en su 'contexto operacional' . Si tu estrategia no se adapta a dónde y cómo trabaja tu equipo realmente, estarás aplicando recetas genéricas a un entorno que es completamente único.
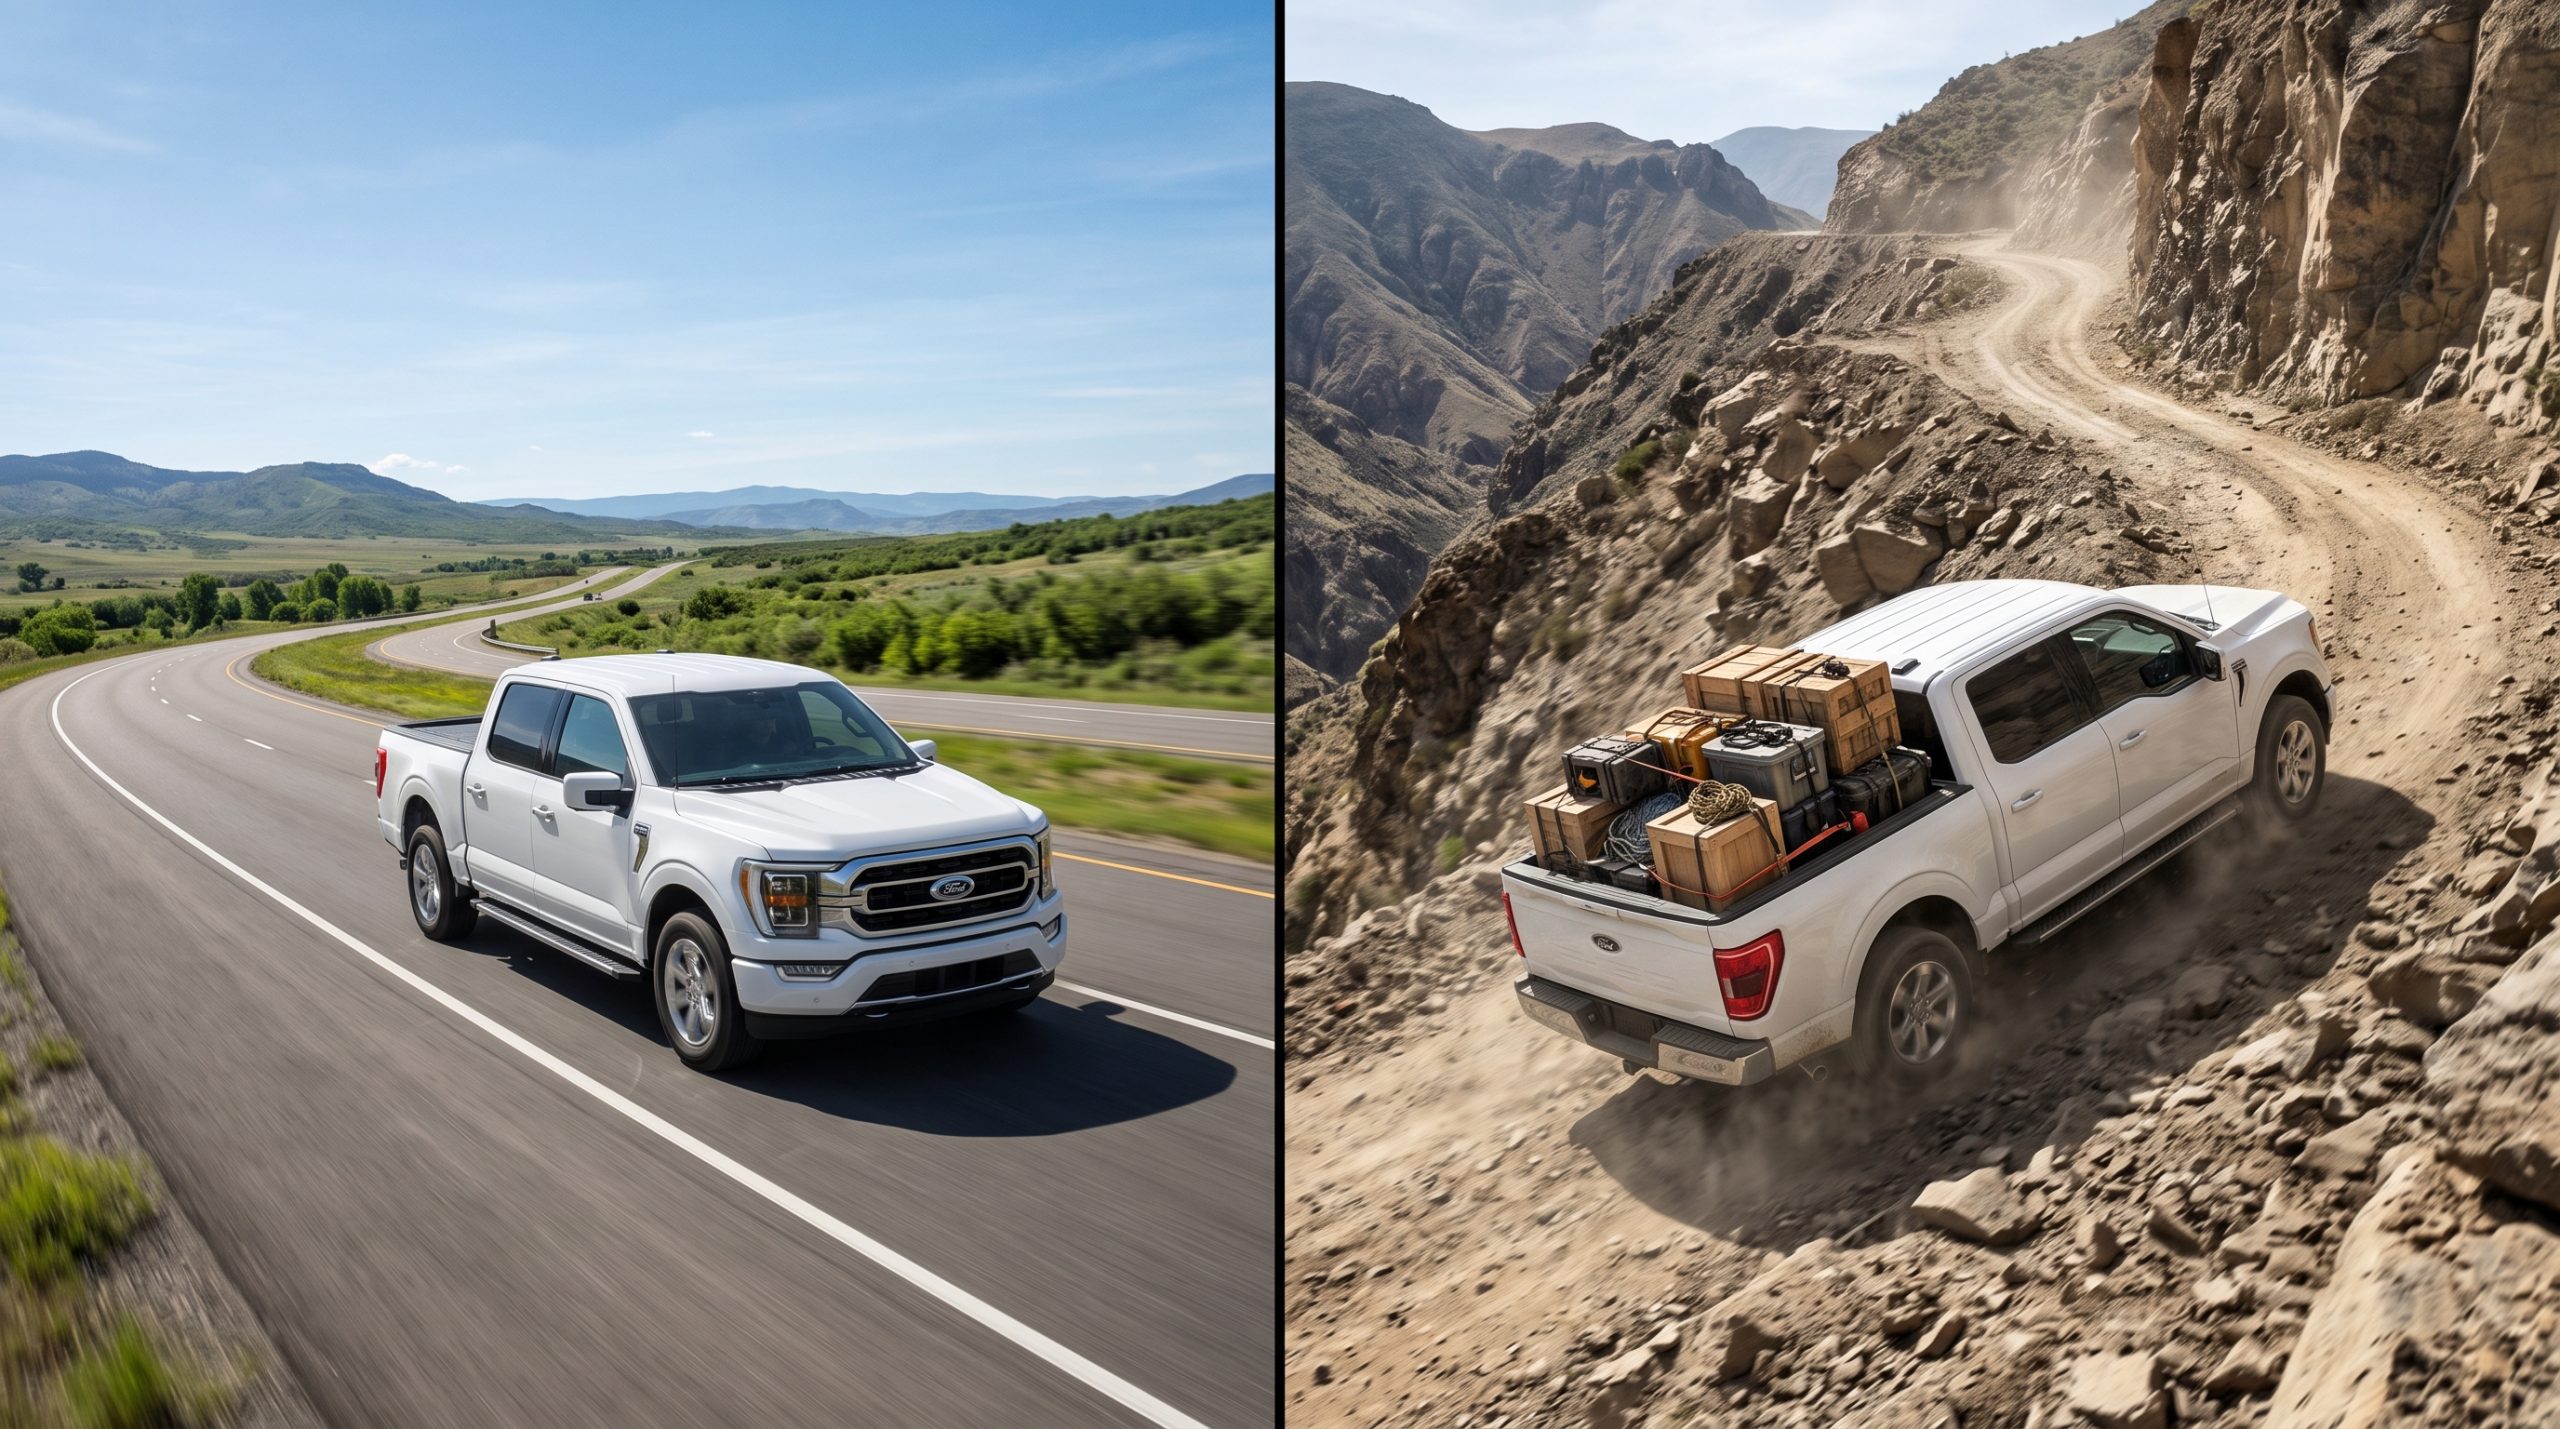
Mira este ejemplo sencillo: te compras un pickup. Ahora imagina dos situaciones de trabajo completamente distintas. En la primera, manejas el vehículo en carretera abierta, libre y sin ninguna carga. En la segunda, ese mismo pickup tiene que transitar todos los días por caminos sin pavimentar, subiendo grandes pendientes en la montaña y con la cama del vehículo cargada al límite de su capacidad.
Aunque el vehículo es exactamente el mismo, el desgaste, las exigencias mecánicas y los puntos críticos de fallo son mundos totalmente opuestos. Sería poco práctico aplicarles el mismo plan genérico de mantenimiento que viene en la guantera, ignorando cómo, cuánto peso y dónde están trabajando realmente.
En la planta pasa exactamente lo mismo con activos de gran valor. Como bien señala una perspectiva clave en la gestión de activos: en ausencia de algo mejor, el manual del fabricante es un buen punto de partida, pero no es necesariamente la mejor estrategia para mantener tu equipo.
Si nos limitamos a seguir ese estándar genérico, nos exponemos a dos escenarios posibles:
Intervenir el equipo más de lo necesario: Detenemos la producción de forma injustificada y, debido a la manipulación excesiva, corremos el riesgo de afectar el equipo negativamente introduciendo fallas humanas en el reensamble.
No protegerlo adecuadamente: Dejamos al activo expuesto y sin la cobertura necesaria, lo que tarde o temprano provocará una falla imprevista que detenga la operación.
El verdadero reto de la confiabilidad no es hacer más mantenimiento por el simple hecho de hacerlo, sino encontrar el balance exacto diseñado para tu contexto operacional real.
El RCM no nació en la oficina de unos consultores que querían inventarse un esquema de papel el día de ayer. Nació en 1975 en la aviación civil, por pura necesidad de vida o muerte. Piénsalo: si vas volando con cientos de pasajeros a 30,000 pies de altura y una pieza empieza a hacer un ruido extraño, no te puedes orillar en la nube para ver qué pasa. El riesgo real obligó a rediseñar toda la estrategia. En 1986, John McCrae y su gente de Aladon adaptaron este marco para la industria.
Aquí va una mini cátedra de RCM en cinco segundos: listo las funciones primarias, secundarias y ocultas de mi equipo. El objetivo del mantenimiento no es mantener las máquinas funcionando porque sí. El verdadero propósito es preservar la función del sistema en su contexto operacional presente.
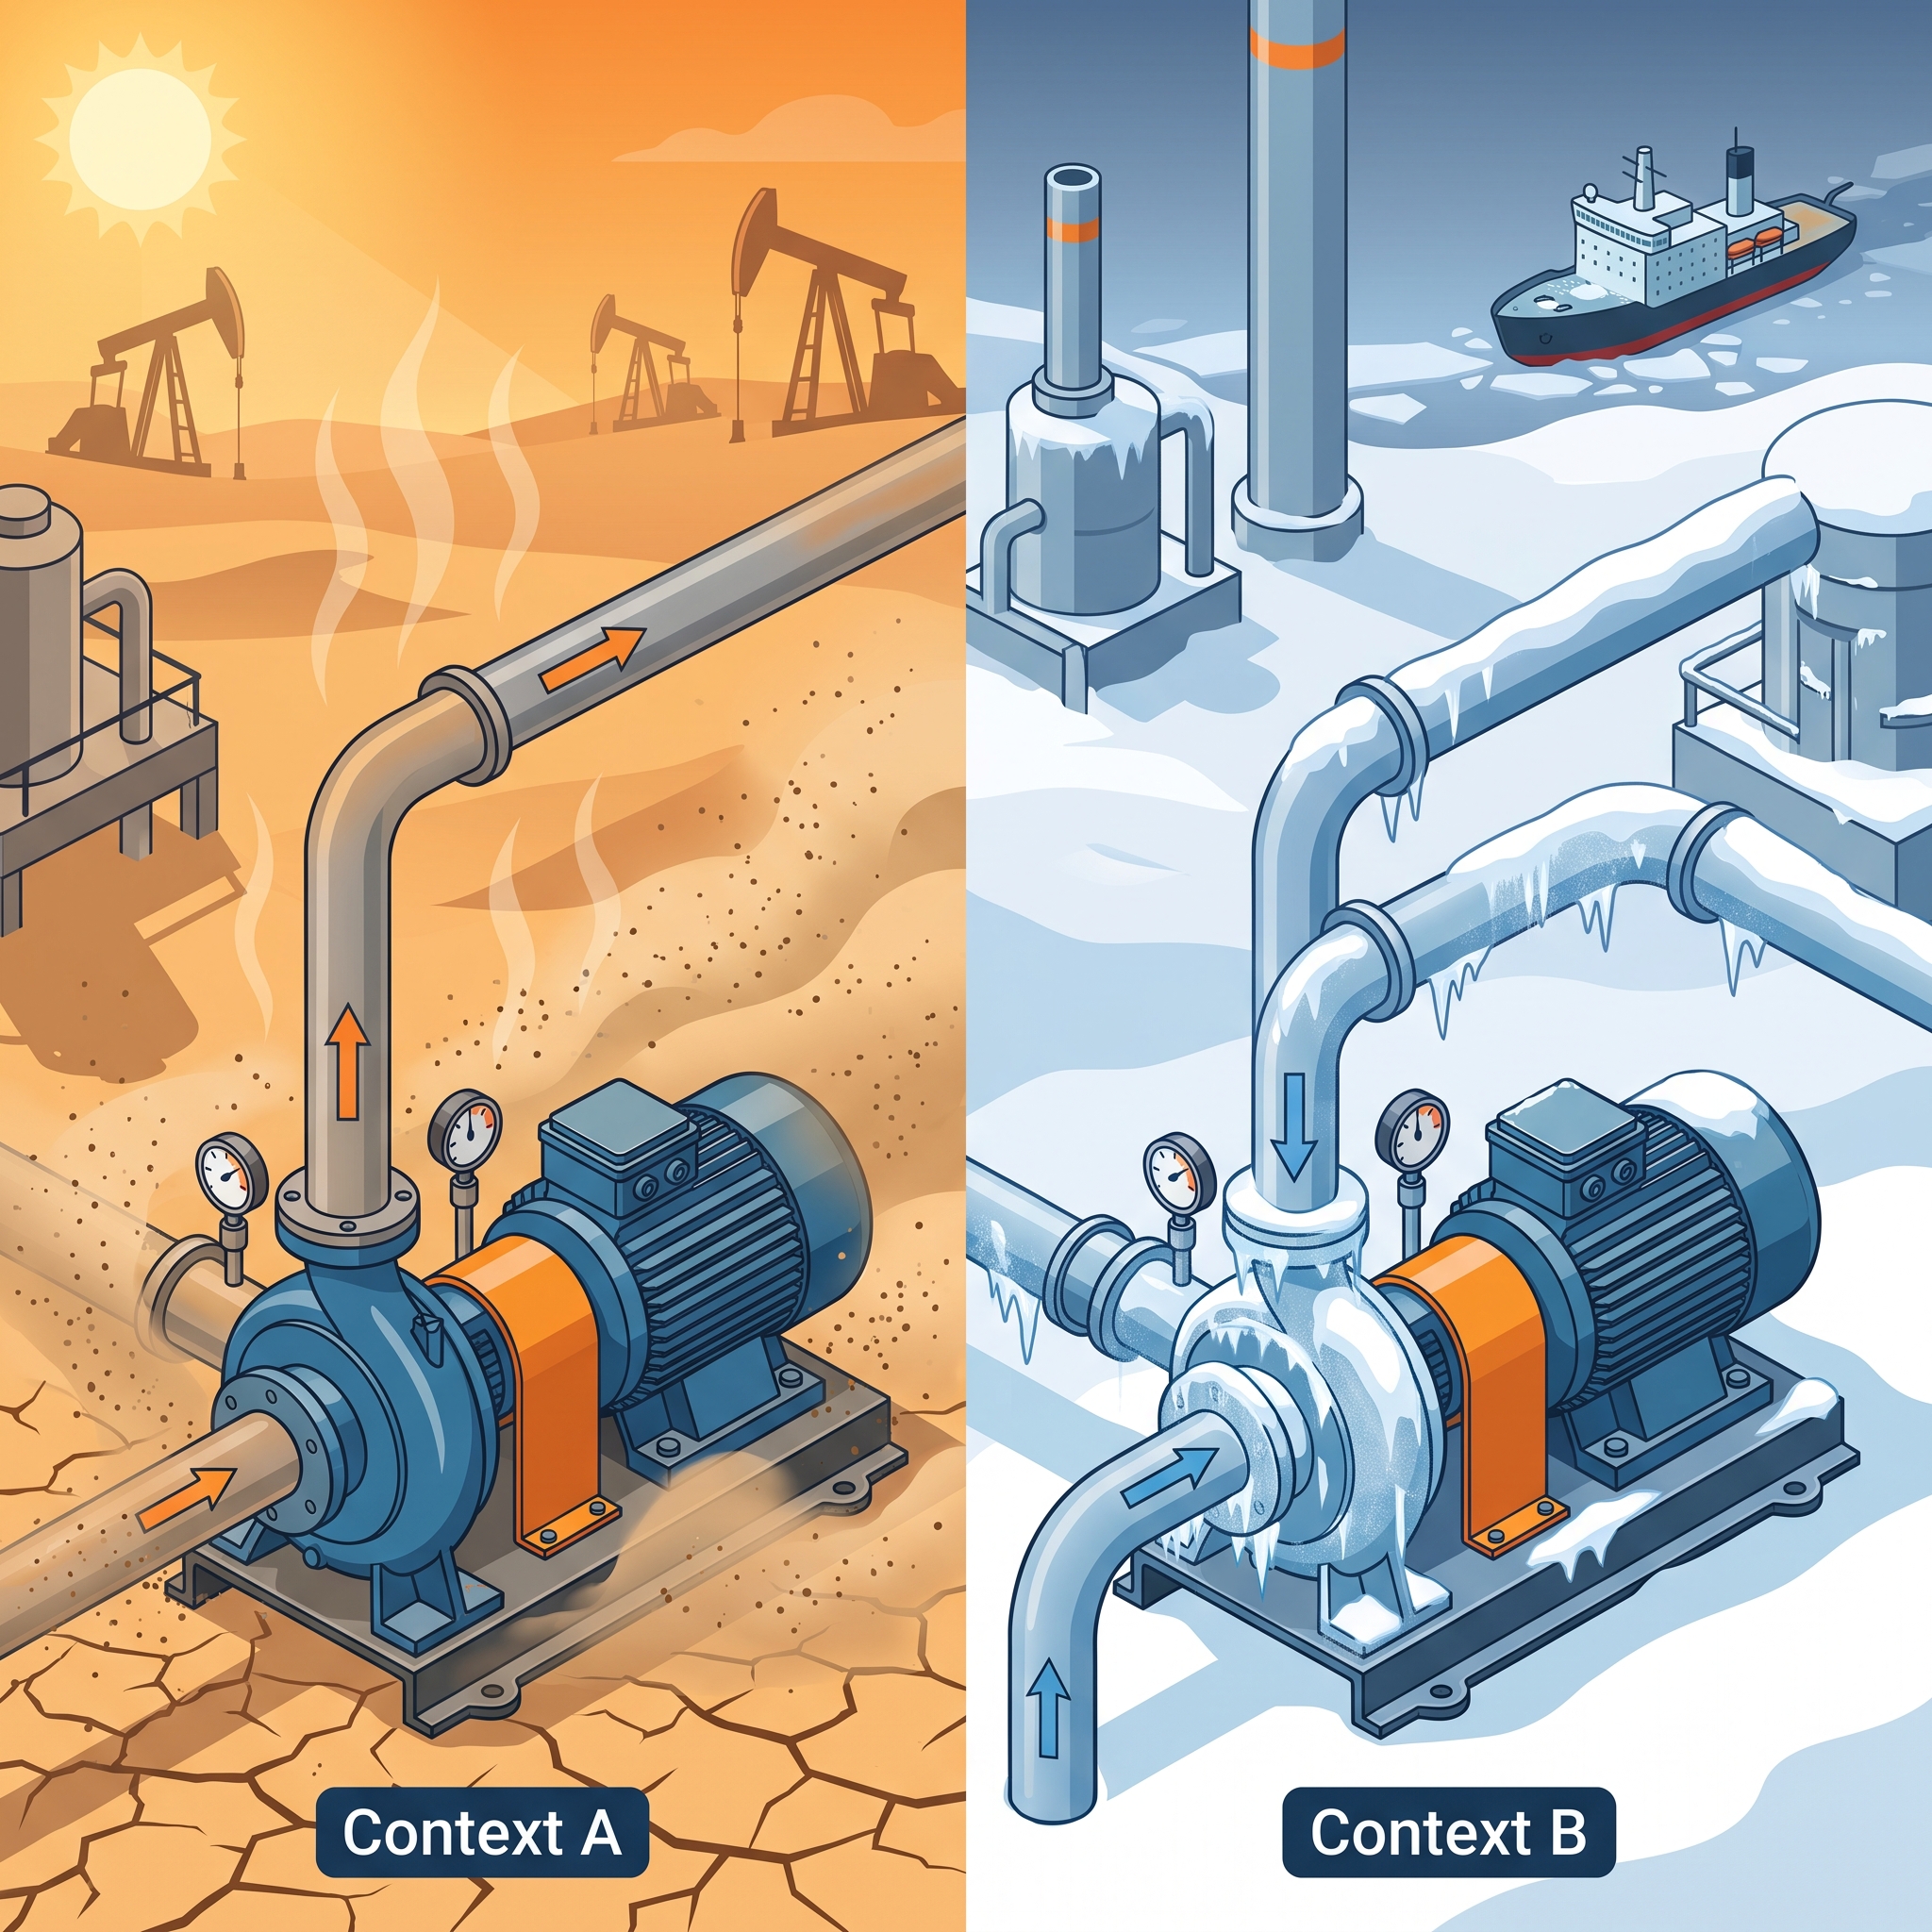
El enfoque tradicional nos dice: "una bomba es una bomba; el fabricante dice que cambies los sellos cada seis meses, así que cambialos y listo". Pero el RCM desafía esta inercia y nos obliga a examinar qué hace esa bomba en tu planta específica, bajo qué clima opera y a qué volumen de producción trabaja.
No requiere el mismo plan de mantenimiento una bomba centrífuga que alimenta el sistema de enfriamiento crítico de un reactor principal, que una bomba idéntica destinada a transferir agua de desecho con redundancia instalada. El activo es el mismo, pero sus funciones y las consecuencias de su falla son mundos opuestos. Usando el árbol lógico de siete preguntas de la norma SAE JA1011, analizamos críticamente cada modo de falla para definir qué hacer. Ahí es donde decidimos cuándo aplicar mantenimiento predictivo y cuándo, sin miedo al éxito, dejar correr a la falla porque el impacto es nulo.
Durante décadas la industria se rigió por el mito de la "curva de bañera", asumiendo que los equipos fallan de forma predecible: cuando son muy nuevos (por fallas de manufactura) o cuando son muy viejos (por desgaste físico). Esto justificaba los costosos desarmes y reparaciones cíclicas preventivas basadas solo en el tiempo transcurrido.
Pero los estudios de aviación civil que dieron origen al RCM demostraron que alrededor del 89% de los fallos en componentes complejos son totalmente aleatorios, ¡casi el 90%!. La edad del componente tiene nula relación con su probabilidad de fallo. Un pico de tensión, un contaminante microscópico o un error de operación ocurren cuando ocurren, sin avisar.
Por lo tanto, desmontar un motor que está nítido solo porque el calendario dice que cumplió un año no solo es un desperdicio de plata, sino que introduce riesgos de fallas infantiles por errores en el reensamble. Si el activo está nítido, ¡no lo toques!.
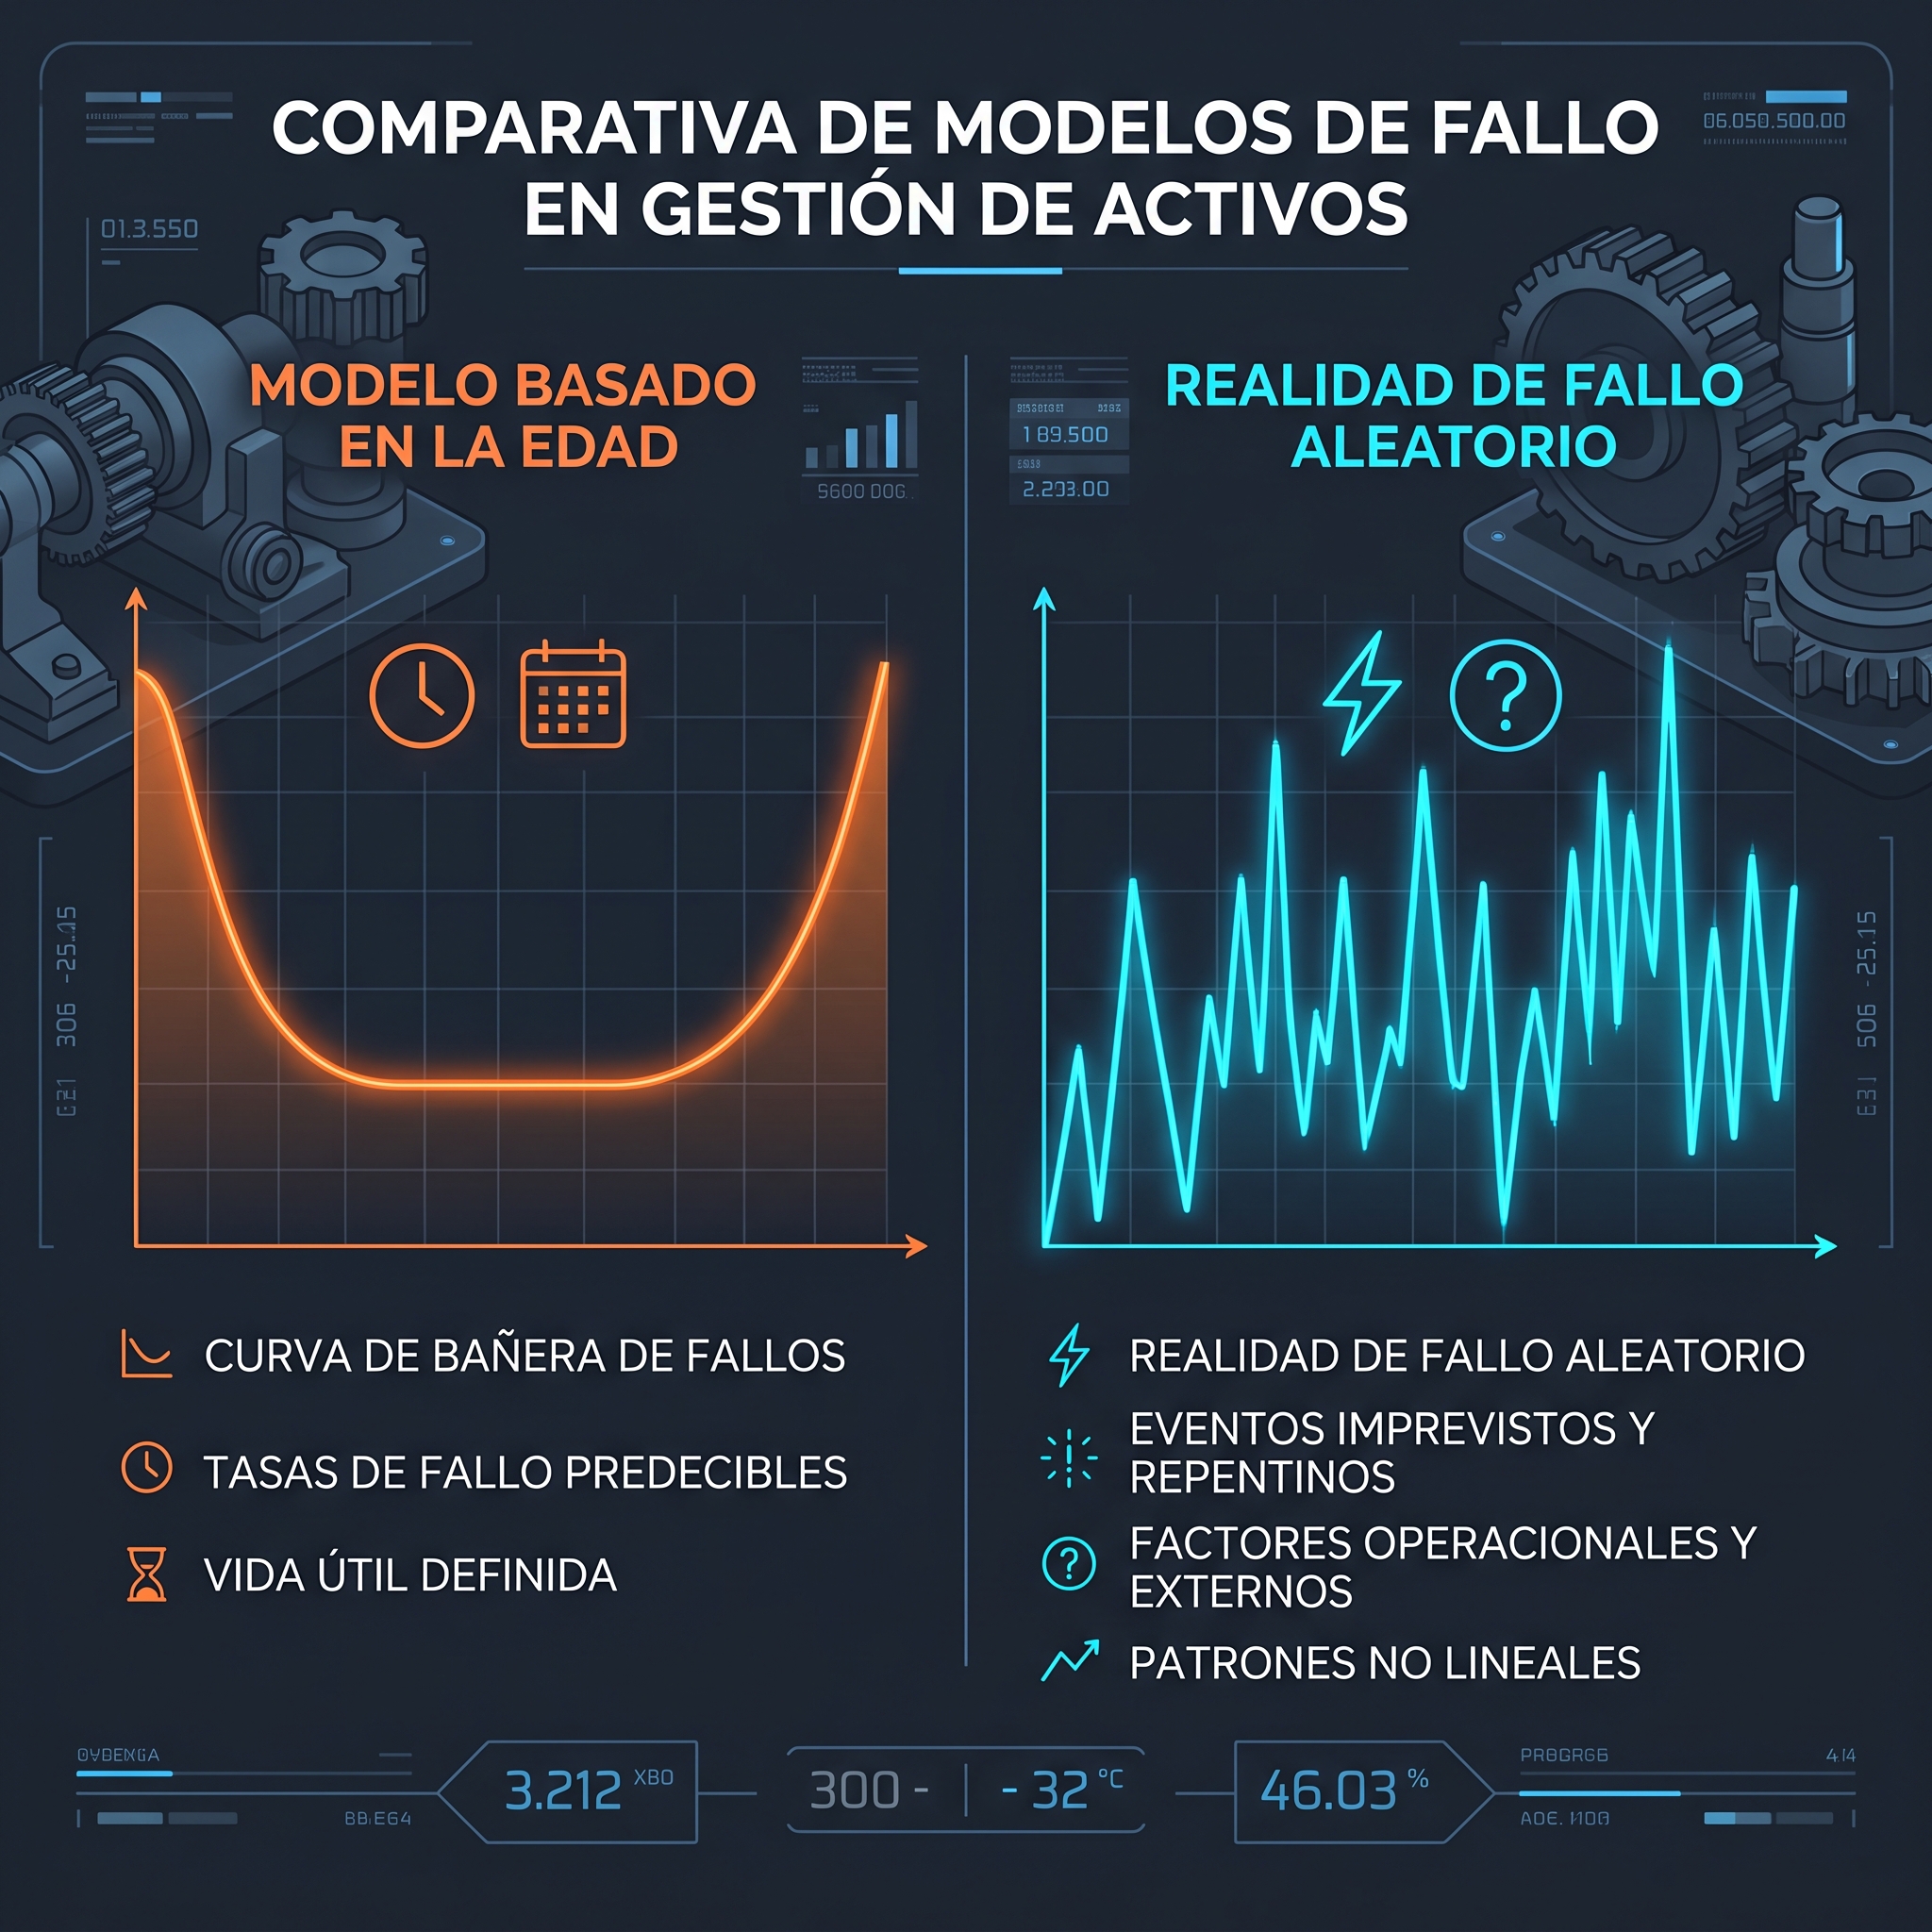
El manual del fabricante es una guía de referencia técnica valiosa, pero jamás debe ser tu estrategia de mantenimiento definitiva. El fabricante original diseña su manual bajo un supuesto teórico estándar, ignorando por completo el contexto operativo y la criticidad de tu activo, el perfil de tus operarios o tus metas de negocio.
Las plantas que se atreven a aplicar este enfoque logran reducir hasta en un 50% las tareas preventivas cíclicas innecesarias, optimizando sus recursos y aumentando drásticamente la disponibilidad de sus activos críticos. No se trata de hacer más mantenimiento, sino de hacer el correcto según las demandas reales del terreno. Y recuerden lo que decía Peter Drucker: "La cultura se desayuna a la estrategia". Si tu equipo de mantenimiento no entiende el porqué de la estrategia, cualquier plan que hagas se va a desperdiciar.
¡Nos toca diseñar estrategias basadas en el contexto operacional real!